AI时代的抉择 以“信”筑基,行稳“智”远——互联网数据服务的破局之道
当生成式AI以前所未有的速度迭代,当大模型参数量从亿级跃升至万亿级,当“智能体”开始接管搜索、推荐、客服甚至决策——互联网数据服务行业正站在一个关键的十字路口。一面是AI带来的效率革命与想象空间,另一面是数据滥用、隐私泄露、算法偏见与“幻觉”频发的信任危机。在这场技术与伦理的赛跑中,行业必须做出抉择:是狂飙突进、先跑再说,还是以“信”筑基、行稳“智”远?
一、AI的“智”,离不开数据的“质”与“信”
互联网数据服务的核心价值,从来不只是“数据搬运”或“管道流量”。在AI时代,数据是燃料,但燃料若掺了杂质,引擎反而会爆震。训练一个智能客服,若语料中充满误导性问答、广告噪音或歧视性表达,结果只能是“智能降级,智障升级”。
以信筑基,意味着数据服务商必须建立全生命周期的质量与信任体系:
来源可信:数据采集须合规授权,杜绝黑灰产爬虫、窃取隐私。
处理可信:清洗、标注、脱敏环节需要可审计、可追溯。
* 使用可信:向AI企业输出数据时,不能牺牲用户权益,更不能制造信息茧房或操纵舆论。
没有“信”,AI越智能,用户越恐惧。此前某大模型因引用未经证实的医疗数据给出错误建议,就是活生生的教训。互联网数据服务者的第一责任,是为AI装好“信任刹车”。
二、行业现状:三种“异化”威胁信任根基
当前互联网数据服务中,三种倾向正在动摇“信”的基石:
1. 贪快求全的“数据注水”:为冲刺大模型训练效率,部分服务商大量录入未经核验的网络文本、洗稿内容、机器问答,造成模型输出“看似有理、实则胡说”。
2. 隐秘的隐私交换:免费API、代理池、扫码连WiFi……数据在没有清晰告知的前提下被汇聚、转卖、乱用,消费者成为“智能燃料”却不自知。
3. 数据孤岛与算法割据:大平台守着自己数据不准接入,小服务商靠灰色手段拼凑。表面是AI缺失数据,实则是信任机制崩塌。
这些急功近利的做法看似加速了AI落地,实则让全行业陷入“用一次错一次,信一次伤一次”的循环。信任构建极难,崩塌却在一瞬。行稳“智”远,首先要忍住那些消耗信任的近路。
三丶行稳“智”远的实践路径:透明、确权、去噪、共生
如何从口号走向地面?互联网数据服务可遵循四步:
透明化分级分类:对数据集来源、适用场景、敏感等级清晰披露。像食品标注成分一样标注数据“成分”,供AI开发者事前评估。
加固数据确权与脱敏技术:运用联邦学习、差分隐私、可信执行环境等技术,做到“数据可用不可见,知识可用不可泄”。
主动去噪与人类反馈清洗:引入首席信任官或数据伦理委员会,以大筛查、人机结合质检等方式清洗有毒和偏见数据。
构建共生生态:运营商、云服务、行业联盟共同扶正拒灰;建立可信数据空间与标注标准,让小机构和独立开发者也享有高质量合规数据。
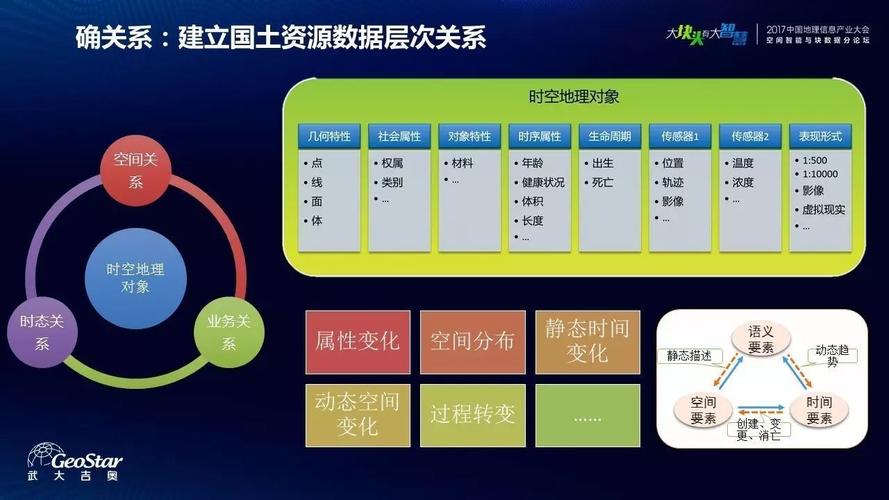
目前已有先行者。中国多家数据交易所推行的“三权分立”数据的登记、评估、交易试点,以及信通院主导的数据信托沙盒,都在朝向能验证、追责明确的方向探索。一旦建成可量化的“确定性信任经济”,AI才能成为规模应用的靠谱引擎。
四、AI应是可信的放大镜,而非湮没信任的魔境
今天在选择技术路线时,每一家互联网数据服务商都在回答一个终极问题——我们只是在满足参数驱动的“嗜血需求”,还是在铸造可以托付的智能基础设施?
孟子云:“敬人者,人恒敬之;爱人者,人恒爱之。”对待用户的每个字节,唯有以敬畏心采集、用责任心治理,做到可查、可控、可告、可诉,才有可能不再困于短期主义,而在人工智能的大航海时代建设真正的智信驾驶舱。以信筑基,行稳以致千里。
如若转载,请注明出处:http://www.hmiexo.com/product/42.html
更新时间:2026-09-19 23:55:04